Kapitel 4 · vollständige deutsche Übersetzung
KI in Medizin und Augenheilkunde
Kapitel 4: Anwendungen künstlicher Intelligenz in der Medizin
- Einleitung
- Beispiele für KI-Techniken in der klinischen Praxis
- Beispiele für KI-Techniken in der Augenheilkunde
- Beispiele für KI zur Erkennung des Keratokonus
4.1 Einleitung
Der Einsatz künstlicher Intelligenz in der Medizin soll verborgene, nützliche Informationen aus Daten erschließen und klinische Entscheidungen unterstützen. KI kann bei Diagnose und Therapieauswahl helfen, Risiken einschätzen, Krankheiten klassifizieren, medizinische Fehler verringern und die Produktivität verbessern.
Mögliche Datenquellen sind demografische Angaben, Notizen medizinischer Leistungserbringer, medizinische Bilder, Laborergebnisse, genetische Tests sowie Aufzeichnungen medizinischer oder tragbarer Geräte wie Smartwatches. Die leichte Verfügbarkeit dieser Daten in elektronischen Gesundheitsakten und intelligenten, mit Sensoren, Netzverbindung und Cloud-Speicher ausgestatteten Geräten eröffnet Möglichkeiten für das Management medizinischer Informationen - vom Patienten, Arzt und Krankenhaus bis zu Gesundheitspolitik und Entscheidungsträgern.
4.2 Beispiele für KI-Anwendungen in der klinischen Praxis
4.2.1 Als Screeninginstrument
- Analyse radiologischer Aufnahmen (Projektions- oder CT-Bilder), Schätzung der Wahrscheinlichkeit einer Erkrankung und Markierung von Befunden, die Radiologen interpretieren müssen. Ein wichtiges Beispiel ist das KI-Screening von Röntgenbildern auf COVID-19 (Minaee, Kafieh, Sonka, Yazdani, & Jamalipour Soufi, 2020; Shi et al., 2020).
- Analyse von Fundusbildern zur Erkennung sehbedrohlicher Befunde, bei denen eine Überweisung an die Augenheilkunde erforderlich ist. Das FDA-zugelassene IDx-DR-System untersucht Netzhautbilder und identifiziert überweisungsbedürftige Personen und sehbedrohliche diabetische Retinopathie (Van Der Heijden et al., 2018).
- In Großbritannien wurde eine KI-basierte Chat-Anwendung eingesetzt, die zwischen Personen unterscheidet, die lediglich Beruhigung benötigen, und solchen, die ärztlich untersucht werden müssen. Dadurch sollen das Gesundheitssystem entlastet und Ressourcen auf Personen mit tatsächlichem Bedarf gelenkt werden (W. Wang & Siau, 2018).
- Hauttumoren wie Melanome können mit hoher, expertenähnlicher Genauigkeit diagnostiziert und von Nävi unterschieden werden (Esteva et al., 2017).
4.2.2 Als Instrument der Prognoseeinschätzung
- Schätzung der Überlebenszeit nach Behandlung eines Aderhautmelanoms (Damato, Eleuteri, Fisher, Coupland, & Taktak, 2008).
- Schätzung der Überlebenszeit und der Rezidivrate bei Brusttumoren (Cirkovic, Cvetkovic, Ninkovic, & Filipovic, 2015).
4.2.3 Als Therapieunterstützung
- Unterstützung bei der Planung einer Strahlentherapie, um die Belastung gesunder Gewebe zu minimieren (C. Wang, Zhu, Hong, & Zheng, 2019).
- Unterstützung bei der Wahl optimaler Therapiestrategien bei Sepsis auf der Intensivstation. Wenn kein eindeutiges Protokoll vorliegt, kann bestärkendes Lernen eine geeignete Vorgehensweise auswählen (Komorowski, Celi, Badawi, Gordon, & Faisal, 2018).
4.2.4 Als Ersatz für einen Leistungserbringer
Es ist auf absehbare Zeit unwahrscheinlich, dass KI Ärztinnen und Ärzte vollständig ersetzt. Sie kann bestimmte Aufgaben jedoch konsistenter, schneller und reproduzierbarer als Menschen ausführen, etwa die Schätzung des Knochenalters auf Röntgenbildern (Tajmir et al., 2019), die Diagnose bestimmter Netzhauterkrankungen in OCT-Bildern (De Fauw et al., 2018) oder die Quantifizierung von Gefäßstenosen und anderen Messwerten in Herzaufnahmen (Slomka et al., 2017). Diese Aufgaben sind nicht unbedingt komplex, können aber Zeit beanspruchen, die der Leistungserbringer für anspruchsvollere Aufgaben einsetzen könnte.
4.2.5 Als Unterstützung des Leistungserbringers
Mehrere Studien zeigen, dass die Synergie zwischen KI und medizinischem Leistungserbringer bessere Ergebnisse liefert als jede Seite allein. Sie verbessert die Möglichkeit, klinische Entscheidungen in Echtzeit zu unterstützen und dadurch die Anstrengungen für eine präzise Gesundheitsversorgung zu verbessern (Sitapati et al., 2017).
4.3 Beispiele für KI-Anwendungen in der Augenheilkunde
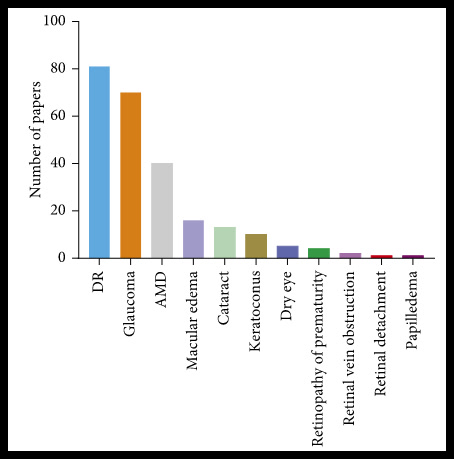
Im Folgenden werden wichtige Studien zu Erkrankungen der Augenheilkunde genannt, bei denen KI eingesetzt wurde. Abbildung 38 ordnet diese nach der Zahl der durchgeführten Studien.
4.3.1 Diabetische Retinopathie
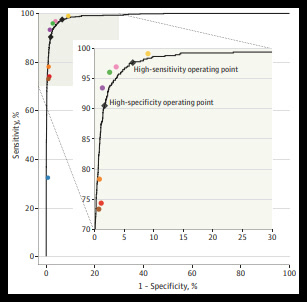
IDx-DR ist eine der wichtigsten praktischen Anwendungen. Das System wurde mit FDA-Zulassung kommerziell zur Untersuchung auf diabetische Retinopathie bei Menschen über 21 Jahren in der primärärztlichen Versorgung eingeführt, ohne dass ein Augenarzt anwesend sein muss. Die Untersuchung ist nicht invasiv und benötigt keine Pupillenerweiterung. In der Praxis erreichte das System bei der Erkennung überweisungsbedürftiger Fälle eine Genauigkeit von annähernd 90 % (Van Der Heijden et al., 2018).
Das System wurde mit 128.175 Bildern trainiert und mit 9.963 Bildern getestet. Die Trainingsbilder wurden von 54 US-board-zertifizierten oder sich im vierten Weiterbildungsjahr befindenden Augenärzten beurteilt, im Mittel von 3–7 Ärzten pro Bild. Für die Testgruppe wurden die sieben Ärzte mit der höchsten Übereinstimmung ausgewählt. Verwendet wurden künstliche neuronale Netze und das auf ImageNet vortrainierte Inception-v3-Netz mit Batch-Normalisierung zur Beschleunigung des Lernens.
4.3.2 Glaukom
- Li und Mitarbeitende untersuchten die Erkennung glaukomatöser Optikusneuropathie. Das KI-Modell wurde mit einer Fundusdatenbank aus 48.116 Bildern trainiert, davon 8.000 Testbilder. Die Genauigkeit betrug bis zu 98,6 %. Häufigste Ursachen falsch-negativer Ergebnisse waren pathologische und hohe Myopie; falsch-positive Ergebnisse standen mit Myopie und vergrößerter physiologischer Exkavation in Verbindung (Li et al., 2018).
- Muhammad und Mitarbeitende untersuchten den Verdacht auf Offenwinkelglaukom anhand von Swept-Source-OCT mit mehreren Karten. Die RNFL-Karte erreichte 93,1 % Genauigkeit und war damit genauer als konventionelles OCT und die konventionelle Gesichtsfelduntersuchung (Muhammad et al., 2017).
- Asaoka und Mitarbeitende unterschieden präglaukomatöse von normalen Gesichtsfeldern. Die Datenbank umfasste 171 Gesichtsfeldbilder; Gesamtabweichung, mittlere Abweichung und Standardabweichung dienten als Eingaben eines vorwärtsgerichteten neuronalen Netzes. Die Genauigkeit bei der Erkennung präglaukomatöser Gesichtsfelder betrug 92,6 % (Asaoka, Murata, Iwase, & Araie, 2016).
4.3.3 Altersabhängige Makuladegeneration
Studien umfassten die Diagnose anhand von OCT-Bildern (Treder, Lauermann, Eter, & Ophthalmology, 2018), die Erkennung aktiver Neovaskularisation (Chakravarthy et al., 2016), die Vorhersage des zukünftigen Bedarfs an wiederholten Injektionen (Bogunović et al., 2017) und die Einschätzung des aktuellen Bedarfs an Antiangiogenese-Injektionen (Prahs et al., 2018).
4.3.4 Katarakt
Gao entwickelte ein neuronales Netz zur Diagnose und Graduierung der senilen Katarakt mit hoher Genauigkeit (Gao, Lin, & Wong, 2015). Ein KI-Screening auf kongenitale Katarakte könnte wegen der Vermeidung vermeidbarer Erblindung durch frühe Diagnose besonders bedeutsam sein (Liu et al., 2017).
KI spielt auch bei der neuen Generation von Formeln zur Berechnung der Intraokularlinsenstärke eine Rolle, etwa Hill-RBF, Kane und PEARL-DGS (Cheng et al., 2020). Hill-RBF ist die bekannteste Formel und online verfügbar. Eingaben sind die anteroposteriore Augenlänge, Vorderkammertiefe sowie Hornhautkrümmungswerte und Achse. Zur Verbesserung der Genauigkeit können zentrale Hornhautdicke, Linsendicke und White-to-White-Distanz ergänzt werden. Die Genauigkeit innerhalb von 0,5 dpt beträgt 71,2 % und ist vergleichbar mit oder besser als Formeln der dritten und vierten Generation (Darcy et al., 2020).
4.3.5 Verschiedene Anwendungen
Poplin und Mitarbeitende trainierten ein KI-Netz, das aus Fundusbildern Alter, Geschlecht, Raucherstatus, systemischen Blutdruck und eine frühere kardiale Erkrankung vorhersagen konnte (Poplin et al., 2018). Zhou und Mitarbeitende entwickelten ein KI-System, das bei Alzheimer-Erkrankung vorhandene Netzhautveränderungen erkennen kann, die ein Mensch nicht identifiziert; hierfür wurde ein Patent angemeldet (Zhou, Sinai, Moore, & Wong, 2006).
Dies ist nur eine kleine Auswahl der KI-Anwendungen in der Augenheilkunde. Die wichtigsten Anwendungen bei der Keratokonusdiagnostik werden im Folgenden gesondert dargestellt.
4.4 KI-Anwendungen zur Erkennung des Keratokonus
Im Folgenden werden wichtige Studien zu KI-Anwendungen bei Keratokonus beschrieben. Tabellen 4 und 5 fassen Algorithmen, Stichproben, Ergebnisse sowie Vor- und Nachteile der Studien zusammen.
4.4.1 Keratokonusdiagnostik mit biomechanischen Eigenschaften und Regressionsalgorithmen
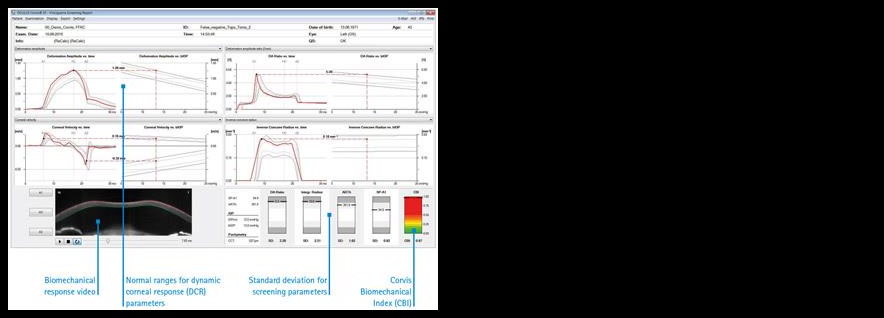
Corvis ST zeichnet die Reaktion der Hornhaut auf einen definierten Luftstoß mit einer hochauflösenden Scheimpflug-Kamera auf. Es nimmt 4.300 Bilder pro Sekunde auf und ermöglicht eine genaue Messung von Hornhautdicke und Augeninnendruck sowie biomechanischen Eigenschaften (Roberts, 2016).
Zwei wichtige Indizes zur Erkennung früher Keratokonusstadien sind der Corvis Biomechanical Index (CBI), der ausschließlich aus Corvis-Informationen mittels Regression entwickelt wurde, und der Tomography and Biomechanical Index (TBI), der Regression und Random Forest kombiniert und Corvis- mit Pentacam-Informationen verbindet (Abb. 40; Ambrósio et al., 2017; Renato, 2016; Riccardo, 2016).
Der TBI ist genauer als der CBI (98,5 % versus 88,2 %). Beide Indizes können jedoch falsch-negative und falsch-positive Ergebnisse liefern. Bei Werten innerhalb der Grenzwerte 0,5 beziehungsweise 0,29 kann die Entwicklung einer Ektasie nach refraktiver Chirurgie daher nicht zu 100 % ausgeschlossen werden (Fernández, Rodríguez-Vallejo, & Piñero, 2019).
4.4.2 Keratokonusdiagnostik mit Support Vector Machine
Die Support Vector Machine ist ein überwachter Lernalgorithmus. Sie klassifiziert Trainingspunkte in einem n-dimensionalen Raum durch eine trennende Hyperebene mit n-1 Dimensionen so, dass der Abstand zwischen den nächstgelegenen Punkten verschiedener Klassen maximal wird. Zwei Punktgruppen in einem zweidimensionalen Raum werden beispielsweise durch eine gerade Linie getrennt (Cortes & Vapnik, 1995).
SIRIUS nutzt diese Methode, um Bilder anhand der Indizes SIf, SIb, RBFf, BCVf, BCVb, RMS(HOA) und THKmin vier Gruppen zuzuordnen: keratokonuskompatibel, verdächtig, normal und abnormal. Die Klassifikationsgenauigkeit lag über 97 % (Arbelaez et al., 2012). Eine Studie verglich 25 Algorithmen zur Klassifikation von Hornhautbildern eines AS-OCT-Geräts (CASIA SS-1000, Tomey). Nach Auswahl der acht diskriminativsten Indizes erreichte die SVM die beste Genauigkeit von 93,6 % (Lavric, Popa, Takahashi, & Yousefi, 2020).
4.4.3 Keratokonusdiagnostik mit konvolutionalen neuronalen Netzen
KeratoDetect wurde an der Ștefan-cel-Mare-Universität in Rumänien entwickelt. Das Modell wurde mit 3.000 künstlich erzeugten Hornhautbildern trainiert, nicht mit Bildern realer Patientinnen und Patienten. Dies ist eine Schwäche; außerdem wurden ausschließlich Krümmungskarten verwendet. Die Genauigkeit bei der Einteilung in normal oder keratokonisch betrug 99,33 % (Lavric & Valentin, 2019).
Eine Studie der Kitasato-Universität in Japan verwendete sechs mit CASIA AS-OCT SS-1000 (Tomey) aufgenommene Karten: vordere und hintere Krümmung, vordere und hintere Höhe, Gesamtbrechkraft und Dicke. Sechs auf ResNet-18 basierende Modelle wurden mit 304 keratokonischen und 239 normalen Bildern trainiert. Die mittlere Gesamtgenauigkeit betrug 99,1 %. Die hintere Höhenkarte war mit 99,3 % am genauesten, gefolgt von der hinteren Krümmungskarte mit 99,1 % (Kamiya et al., 2019).
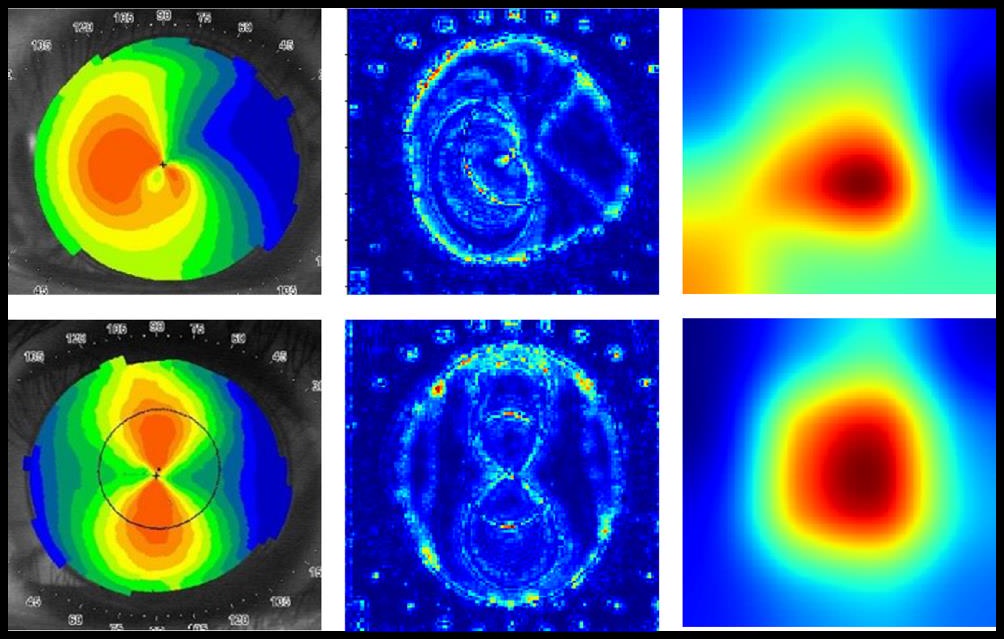
An der National Taiwan University wurden 354 Bilder von 206 Patientinnen und Patienten mit einem TMS-4-Videokeratoskop (Tomey) untersucht. Drei vortrainierte Modelle (VGG16, InceptionV3 und ResNet152) wurden eingesetzt. Die Bilder wurden in normale, keratokonische und subklinische Gruppen aufgeteilt; die ersten beiden dienten dem Training, die dritte der Prüfung. ResNet152 erreichte 95,8 %, die beiden anderen 93,1 %. Die Vorhersage subklinischer Fälle war bei einer Wahrscheinlichkeitsschwelle von 50 % mit 28,5 % unbefriedigend. Pixelweise diskriminative Merkmale und klassenbezogene Heatmaps wurden erstellt, um die Arbeitsweise des Netzes zu verstehen und den Untersuchenden auf auffällige Bildbereiche aufmerksam zu machen (Abb. 41; Kuo et al., 2020).
Eine Studie der Universität Assiut (Ägypten) trainierte mit 2.574 und testete mit 644 Pentacam-Bildern. Verwendet wurden vordere und hintere Höhenkarte, vordere sagittale Krümmungskarte, Dickenkarte und ein kombiniertes Bild dieser vier Karten. Das Modell bestand aus zwei konvolutionalen Schichten und einem vierlagigen neuronalen Netz vor der Ausgabeschicht. Die kombinierte Vier-Karten-Karte erreichte 98,9 %, gefolgt von der hinteren Höhenkarte mit 97,7 %; auch Heatmaps wurden untersucht (Abdelmotaal et al., 2020).
Tabelle 4 – Vergleich früherer Studien (außer CNN):
| Studie/Algorithmus | Verfahren und Stichprobe | Ergebnisse | Vorteile | Nachteile |
|---|---|---|---|---|
| CBI (Vinciguerra et al., 2016), Regressionsalgorithmen | Retrospektive Unterscheidung normaler (478) und keratokonischer (180) Hornhäute mit dem CORVIS-Gerät | Sensitivität 94,3 %, Spezifität 97,5 %, AUC 97,7 %, Genauigkeit 88,2 % | CORVIS ist ein einzigartiges Gerät | Retrospektiv; verdächtige Hornhäute nicht untersucht; falsch-positive und falsch-negative Befunde in einigen Studien |
| TBI (Ambrósio et al., 2017), Regression + Random-Forest | Retrospektive Unterscheidung normaler (480), keratokonischer (204), einseitig keratokonischer (72) und Forme-fruste-keratokonischer (72) Hornhäute | Grenzwert 0,29 zur Erkennung von FFKC; AUC 98,5 %, Sensitivität 90,4 %, Spezifität 96 % | Verknüpft die Möglichkeiten von CORVIS und PENTACAM | Retrospektiv; falsch-positive und falsch-negative Befunde in einigen Studien |
| SIRIUS-SVM (Arbelaez et al., 2012), Support Vector Machine | Retrospektive Klassifikation keratokonischer (877), normaler (1.259), subklinischer (426) und postrefraktiv operierter (940) Hornhäute | KC: Genauigkeit 99,3 %, Sensitivität 98,2 %, Spezifität 95 %; subklinisch: Genauigkeit 97,3 %, Sensitivität 92 %, Spezifität 97,7 % | Training anhand von Merkmalen der vorderen und hinteren Hornhautfläche; SIRIUS (Placido + Scheimpflug) | Retrospektiv; relativ wenige verwendete Merkmale, um Overfitting zu vermeiden – eine Einschränkung der SVM |
Tabelle 5 – Vergleich früherer CNN-Studien:
| Studie/Modell | Verfahren und Stichprobe | Ergebnisse | Vorteile | Nachteile |
|---|---|---|---|---|
| KeratoDetect (Lavric & Valentin, 2019), CNN | Künstlich erzeugte Bilder: 1.500 normal und 1.500 KC; die verwendeten Karten sind nicht eindeutig beschrieben und waren vermutlich auf Krümmungskarten beschränkt | Genauigkeit 99,33 % | – | Keine Bilder realer Patientinnen und Patienten; Kartentypen unklar, vermutlich nur Krümmungskarten |
| Kamiya et al. (2019), CNN/ResNet-18 | Retrospektiv mit AS-OCT, sechs Karten; 239 normal und 304 KC | Gesamtgenauigkeit 99,1 %; hintere Höhenkarte 99,3 %, danach hintere Krümmung 99,1 % | AS-OCT; sechs Karten; vortrainiertes ResNet-18 | Verdächtige Fälle nicht untersucht; Nutzung eines vortrainierten Modells |
| Kuo et al. (2020), CNN (VGG16, InceptionV3, ResNet152) | Retrospektiv mit Videokeratoskop; Training: 170 KC und 156 normal, Test: 28 subklinisch | ResNet152: 95,8 % im Training; 28,5 % bei subklinischen Testfällen | Vortrainierte Modelle; diskriminative Pixelmerkmals- und klassenbezogene Heatmaps zum Verständnis des Modells | Videokeratoskop liefert keine genauen Informationen zur hinteren Hornhautfläche; nur vordere Krümmungskarte; subklinische Fälle wurden unzureichend erkannt |
| Abdelmotaal et al. (2020), CNN | Retrospektiv mit PENTACAM: 1.038 KC, 1.108 normal, 1.072 subklinisch oder Forme fruste; vier Einzelkarten und ein kombiniertes Bild | Kombinierte Vier-Karten-Karte 98,9 %, hintere Höhenkarte 97,7 % | Vier Karten einzeln und kombiniert; PENTACAM; Heatmaps zur Untersuchung der Modellarbeitsweise | Keine unabhängige Testgruppe; keine echten Verdachtsfälle, sondern nur subklinische/Forme-fruste-Fälle |
| Vorliegende Studie | Retrospektive Sammlung/Training und unabhängige Testgruppe mit realen Bildern; Training: 559 KC, 1.217 normal, 167 verdächtig; Test: 13 KC, 366 normal, 43 verdächtig | Beste Netze: vordere Höhenkarte, danach hintere Höhenkarte, vordere refraktive Stärke, äquivalente refraktive Stärke; Genauigkeit/F1-Score 94,5–94,3 % | Neues Netzwerkdesign; Transfer Learning; Data Augmentation; Training mit realen Bildern; große Stichprobe; unabhängige Testgruppe; SIRIUS; Heatmaps; Lesung mit Unterstützung | Trainings-, Validierungs- und Testgruppen unausgewogen; AS-OCT gilt als genauer als SIRIUS; retrospektives Design |